„Die Datumssuche wird nach 100 ms abgebrochen. created fällt stillschweigend auf das Importdatum zurück.“ So beschreibt ein Nutzer in den GitHub-Discussions von Paperless-ngx, was mit seinen langen Scans seit Version 3 passierte: Das Dokument landete im Archiv, nur mit dem falschen Datum, und kein Hinweis in der Oberfläche verriet es. Version 3.2.0, seit der Nacht zum 19-09-2026 stabil, gibt ihm den Regler dafür. Sie bringt außerdem einen Duplikat-Filter, eine Seite für alle Freigabe-Links und einen Umbau der automatischen Zuordnung, den ich für die wichtigste Änderung halte, obwohl er in den Release Notes nur eine Zeile bekommt.
pull, up -d. Stand: Paperless-ngx 3.2.0, geprüft am 19-09-2026.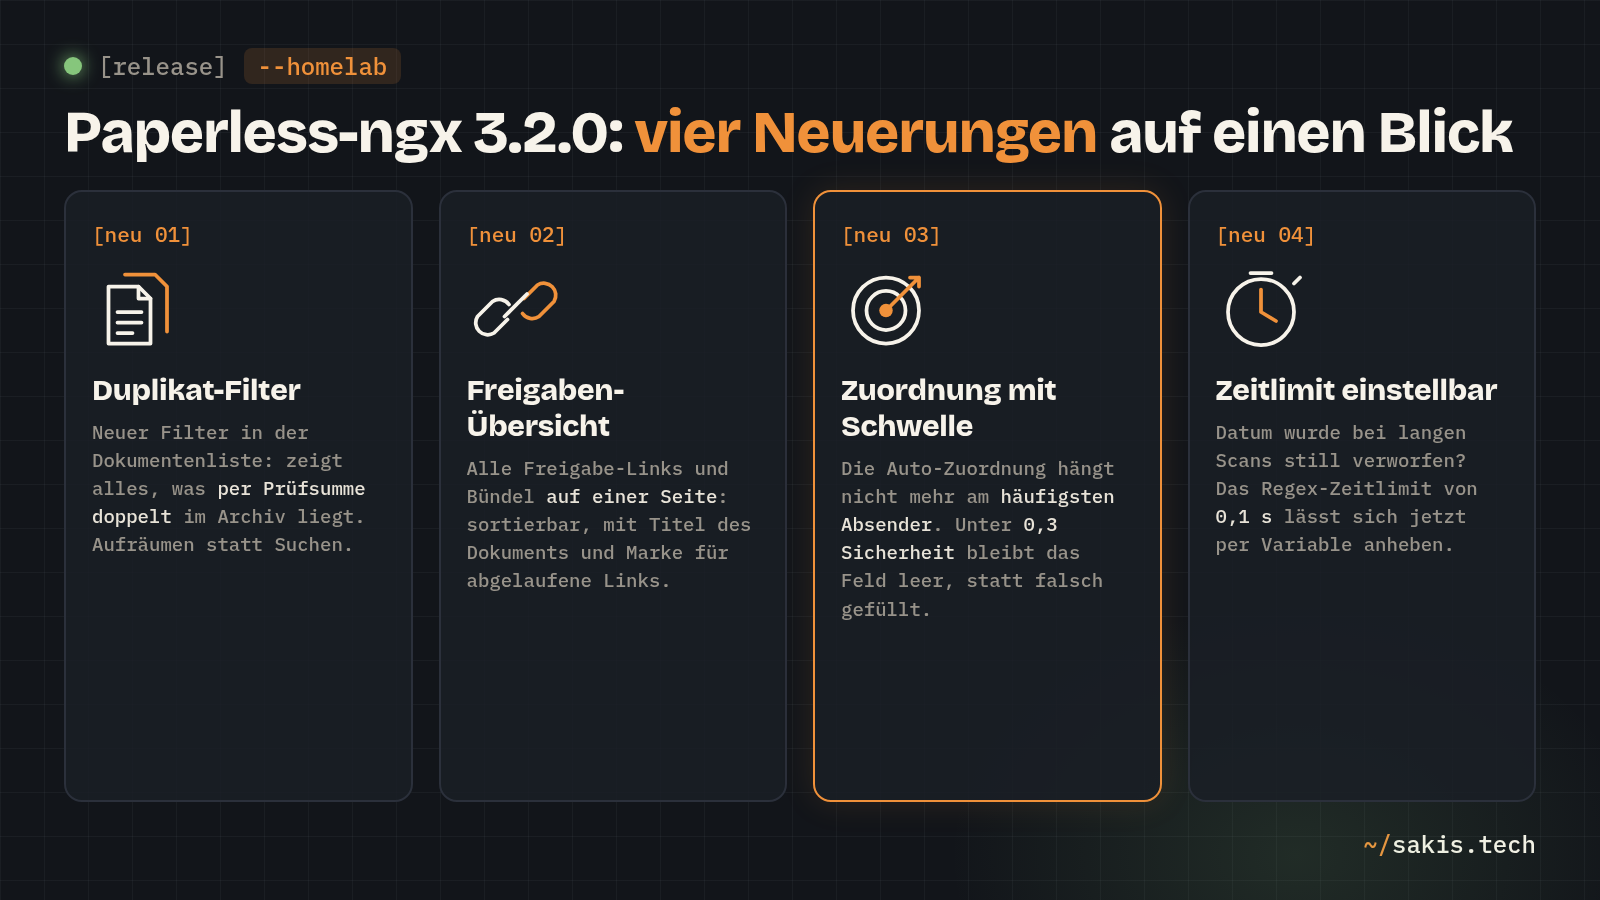
Zuordnung: lieber kein Treffer als ein falscher
Wer bei Korrespondenten oder Dokumenttypen den Zuordnungsalgorithmus „Auto“ wählt, lässt ein kleines Modell an den bereits einsortierten Dokumenten lernen; neue Scans bekommen dann von selbst Absender und Typ. Das funktioniert gut, solange dein Archiv ausgewogen ist. Der Pull Request von dewey, der jetzt in 3.2.0 gelandet ist, beschreibt das Problem an einer Instanz, in der 60 Prozent aller Dokumente von einem einzigen Korrespondenten stammten: Alles, was das Modell nicht einordnen konnte, bekam diesen Korrespondenten, einfach weil er statistisch am wahrscheinlichsten war. Aus „ich weiß es nicht“ wurde „wahrscheinlich die Bank“, und das ist im Archiv schlimmer als ein leeres Feld, weil du es nicht mehr siehst.
Zwei Änderungen beheben das. Erstens gewichtet das Training überrepräsentierte Klassen jetzt herunter, damit der häufigste Absender keinen Startvorteil mehr hat. Zweitens gibt es eine Mindestsicherheit: Liegt die Wahrscheinlichkeit für den besten Treffer unter 0,3, bleibt das Feld leer. Der Pull Request nennt das Prinzip in einem Halbsatz, den ich unterschreiben würde: kein Treffer ist besser als ein schlechter Treffer. Ein leeres Feld fällt dir im Posteingang auf, ein falsch gefülltes nicht.
Die Schwelle steht in der Doku als PAPERLESS_CLASSIFIER_MATCH_THRESHOLD, Standard 0.3, Bereich 0.0 bis 1.0, und gilt für Korrespondent, Dokumenttyp und Speicherpfad. Wer nach dem Update merkt, dass deutlich mehr Dokumente ohne Absender im Posteingang liegen, hat zwei Möglichkeiten: den Wert in docker-compose.env auf 0.2 senken, oder ein paar Wochen von Hand nachsortieren und dem Modell mehr Beispiele geben. Ich würde das Zweite tun. Die neue Gewichtung braucht ein frisches Training, und das läuft laut Doku standardmäßig jede Stunde von allein; nach dem ersten Training mit den neuen Gewichten sortiert sich das meiste wieder ein.
Die Nummer des Pull Requests liegt weit vor denen der übrigen 3.2.0-Änderungen. Das heißt: Jemand hat das Problem vor Monaten sauber analysiert, eine Lösung gebaut und gewartet, bis das Team Zeit für die Prüfung hatte. Solche Beiträge sind der Grund, warum Paperless-ngx nach der Übernahme durch die Community besser geworden ist statt schlechter.
Der Duplikat-Filter
Paperless konnte schon vorher erkennen, dass ein Dokument doppelt da ist; es hat beim Einlesen die Prüfsumme verglichen und in der Dokumentansicht auf ein gleiches Dokument hingewiesen. Was fehlte, war die Liste. Wer sein Archiv aus mehreren Quellen gefüllt hat, etwa aus dem Scanner und zusätzlich aus einem alten Ordner voller PDFs, weiß, dass es Dubletten gibt, aber nicht welche.
3.2.0 ergänzt den Filter-Editor der Dokumentenliste um eine Auswahl „Duplikate“: Dokumente mit Dubletten, Dokumente ohne. Verglichen wird die Prüfsumme der Archivdatei, also der PDF-Kopie, die Paperless beim Einlesen erzeugt. Zwei Scans desselben Briefs, an verschiedenen Tagen gemacht, unterscheiden sich in ein paar Pixeln und tauchen hier nicht auf; das ist ein Filter für echte Datei-Kopien, nicht für ähnliche Dokumente. Dafür ist er schnell: Der Pull Request legt eigens einen Datenbank-Index auf die Prüfsumme an, damit die Abfrage auch bei zehntausend Dokumenten nicht minutenlang läuft.
Wer die Dubletten gar nicht erst haben will, hat weiterhin PAPERLESS_CONSUMER_DELETE_DUPLICATES. Steht die Variable auf true, löscht Paperless eine Datei mit bekannter Prüfsumme direkt aus dem Eingangsordner. Der neue Filter ist der Besen für alles, was vorher schon drin war.
Freigabe-Links auf einer Seite
Freigabe-Links sind Adressen, die ein einzelnes Dokument ohne Anmeldung zugänglich machen, etwa für den Steuerberater; seit 3.0 gibt es auch Bündel, die mehrere Dokumente als ZIP verpacken. Erstellt wurden sie immer am Dokument, und dort blieben sie auch. Wer wissen wollte, welche Links gerade offen sind, musste jedes Dokument einzeln aufrufen.
Jetzt gibt es eine eigene Verwaltungsseite: eine Tabelle mit allen Links und Bündeln, seitenweise, nach Spalten sortierbar, mit dem Titel des Dokuments und einer Markierung für abgelaufene Links. Der Autor merkt im Pull Request selbst eine Nebenwirkung an: Die Tabelle zeigt den Dokumenttitel auch dann, wenn dir jemand inzwischen die Rechte am Dokument entzogen hat, der Link aber noch aktiv ist. Er hält das für vertretbar, weil der Link ohnehin Zugriff aufs ganze Dokument gibt, und das finde ich schlüssig. Abgelaufene Bündel räumt Paperless laut Doku ohnehin nachts um zwei weg, gesteuert über PAPERLESS_SHARE_LINK_BUNDLE_CLEANUP_CRON; die Seite ist vor allem für die Links, die nie ablaufen, weil man beim Erstellen kein Datum gesetzt hat.
Das Zeitlimit für die Datumserkennung
Zurück zum Zitat vom Anfang. Paperless sucht im erkannten Text nach einem Datum, das es als Erstellungsdatum einträgt, mit regulären Ausdrücken, also Suchmustern für Text. Version 3 hat allen Suchmustern ein Zeitlimit von 0,1 Sekunden verpasst, damit ein böses Muster in einer Zuordnungsregel den Server nicht blockiert. Das Limit galt aber auch für die eingebaute Datumssuche, und die braucht auf einem langsamen Prozessor bei einem Dokument mit mehr als etwa 11.500 Zeichen länger als 0,1 Sekunden. Ergebnis: Abbruch, Importdatum statt Briefdatum, eine Warnung im Log, die niemand liest. In Version 2 gab es dieses Limit nicht.
Der Nutzer hat das in Discussion #13654 mit Zeichenzahl und Ursache aufgeschrieben, und mit 3.2.0 ist die Einstellung draußen. Sie heißt PAPERLESS_MATCH_REGEX_TIMEOUT_SECONDS, Standard bleibt 0.1, und die Doku sagt, wann du sie hochsetzen sollst: wenn Datumserkennung oder eigene Zuordnungsregeln bei längeren Dokumenten auf schwacher Hardware abbrechen. Auf einem Raspberry Pi mit vielseitigen Verträgen im Archiv würde ich PAPERLESS_MATCH_REGEX_TIMEOUT_SECONDS=1.0 in die docker-compose.env schreiben und die Container neu starten. Ob du betroffen bist, siehst du an Dokumenten, deren Datum exakt dem Tag des Einlesens entspricht, obwohl der Brief älter ist. Rückwirkend repariert die Einstellung nichts; bereits eingelesene Dokumente behalten ihr Datum, bis du es von Hand änderst.
Kleinere Änderungen, die im Alltag auffallen
- Seitenleiste ausdünnen: Dashboard, gespeicherte Ansichten, Workflows, E-Mail und Doku lassen sich in den Einstellungen einzeln ausblenden. Rein im Browser umgesetzt, laut Pull Request ohne Änderung am Server.
- „Alle auswählen“ mit Ausnahmen: Nach „alle auswählen“ kannst du einzelne Dokumente wieder abwählen, bevor du eine Massenaktion startest. Klingt banal, hat bisher gefehlt.
- Unscharfe Suche hält sich an das Feld: Eine Suche wie
title:rechnug~sollte Tippfehler im Titel abfangen. Bisher verlor die unscharfe Variante die Einschränkung auf den Titel und suchte in allen Feldern; ausgeschlossene Begriffe kamen über die Unschärfe wieder herein. Beides ist behoben. - Konfigurationsseite zeigt, was von außen kommt: Eine Einstellung, die du per Umgebungsvariable gesetzt hast, ließ sich in der Oberfläche scheinbar ändern, ohne dass es wirkte. Jetzt steht dort, dass der Wert woanders gesetzt ist.
- Keine Vorschläge im Posteingang: Die automatischen Vorschläge für Tags und Absender lassen sich für Dokumente im Posteingang abschalten, für alle, die ihre ersten fünfzig Dokumente ohne Zurufe sortieren wollen.
- Erste Anmeldung mit SSO: Wer Paperless mit deaktiviertem Passwort-Login und einem externen Anmeldedienst frisch installierte, landete auf einer Seite mit „Sign Up Closed“ und kam nicht weiter. Der Umweg ist raus.
- Mail-Abruf ohne Überlappung: Lief der geplante Abruf eines Mailkontos noch, wenn der nächste startete, wurden Mails doppelt verarbeitet. Jetzt lässt Paperless den zweiten Lauf aus, solange der erste arbeitet.
- Für geteilte Valkey- oder Redis-Instanzen:
PAPERLESS_REDIS_PREFIXgilt jetzt auch für die Ergebnis-Schlüssel der Aufgabenwarteschlange. Betrifft nur, wer mehrere Dienste an einen Broker hängt.
Update: drei Befehle und ein Export davor
Breaking Changes nennen die Release Notes keine, und der Sprung ist klein: 3.1.0 kam am 27-08-2026, danach drei Fehlerkorrekturen bis 3.1.3 am 04-09-2026. Der Weg aus der Doku ist derselbe wie immer: im Paperless-Ordner docker compose down, dann docker compose pull, dann docker compose up -d. Der letzte Befehl spielt die Datenbank-Migrationen ein. Steht in deiner Compose-Datei latest als Tag, wie in der Vorlage des Projekts, kommt 3.2.0 mit dem nächsten Pull; wer eine Versionsnummer festgepinnt hat, trägt vorher 3.2.0 ein.
Davor der Satz, den ich in jeder Paperless-Meldung schreibe: einmal docker compose exec -T webserver document_exporter ../export, bevor du ziehst. Der Exporter schreibt Dokumente, Vorschaubilder und eine manifest.json mit allen Metadaten in den Export-Ordner, und die Doku ist deutlich, dass ein Export nur in dieselbe Version zurückgespielt werden kann. Läuft nach dem Update etwas schief, ist dieser Ordner dein Weg zurück auf 3.1.3. Wie der Ordner zustande kommt und was sonst noch in der docker-compose.env steht, steht in der Installationsanleitung zu Paperless-ngx; sie gilt mit 3.2.0 unverändert.
Updaten würde ich, und zwar bald, wegen der Zuordnung. Wer in den letzten Monaten den Eindruck hatte, Paperless hänge jedem unbekannten Brief denselben Absender an, bekommt mit 3.2.0 die Erklärung und die Lösung in einem. Der Preis ist ein Posteingang, in dem für ein, zwei Wochen mehr leere Felder stehen als vorher. Das ist der ehrlichere Zustand.
Hat dein Archiv einen Absender, der alles an sich zieht, und wie viele Dubletten fördert der neue Filter bei dir zutage? Schreib beides in die Kommentare, mich interessiert vor allem, ob die Schwelle von 0,3 für deutsche Behördenpost passt.
Wer Paperless noch gar nicht laufen hat: Die Anleitung führt in einer guten halben Stunde bis zum ersten eingelesenen Dokument, und 3.2.0 ist ein guter Stand, um damit anzufangen.
Quellen
- Paperless-ngx v3.2.0: Release Notes auf GitHub (19-09-2026)
- PR #12164: Improve matching by removing bias and adding a minimum match threshold
- PR #13994: Duplicates filter
- PR #14115: Centralized management of share links and bundles
- PR #14085: Allow regex timeout configuration
- Discussion #13654: Datumserkennung bricht bei langen Dokumenten nach 100 ms ab
- PR #14157: Match fuzzy terms in place inside the parsed query
- PR #14165: Don't redirect to signup on first install when regular login is disabled
- PR #14046: Prevent overlapping mail-account processing runs
- Paperless-ngx Doku: Configuration (CLASSIFIER_MATCH_THRESHOLD, MATCH_REGEX_TIMEOUT_SECONDS, TRAIN_TASK_CRON)
- Paperless-ngx Doku: Administration (Updating, Document exporter)
- Paperless-ngx Doku: Advanced Usage (Automatic matching)