„… people can now be shared!" So steht es, mit Ausrufezeichen, in den Release Notes zu Immich v3.3.0, seit dem 07-10-2026 stabil. Vor vier Wochen hatte Version 3.2 die Cluster-Gruppen gebracht: Gesichter werden seitdem über Konten hinweg erkannt, aber das Namensschild klebte weiter jeder für sich dran. Jetzt wandert das Schild mit. Dazu kommt etwas, das auf der Liste nach Kleingedrucktem aussieht und für jeden mit einem schwachen Server das eigentliche Highlight ist: neue Machine-Learning-Modelle, die weniger Arbeitsspeicher brauchen, per Opt-in mit einer Zeile in der Compose-Datei.
Breaking Changes nennen die Release Notes keine; was sich ändert, zeigt das Schaubild. Stand: Immich v3.3.0, geprüft am 08-10-2026.
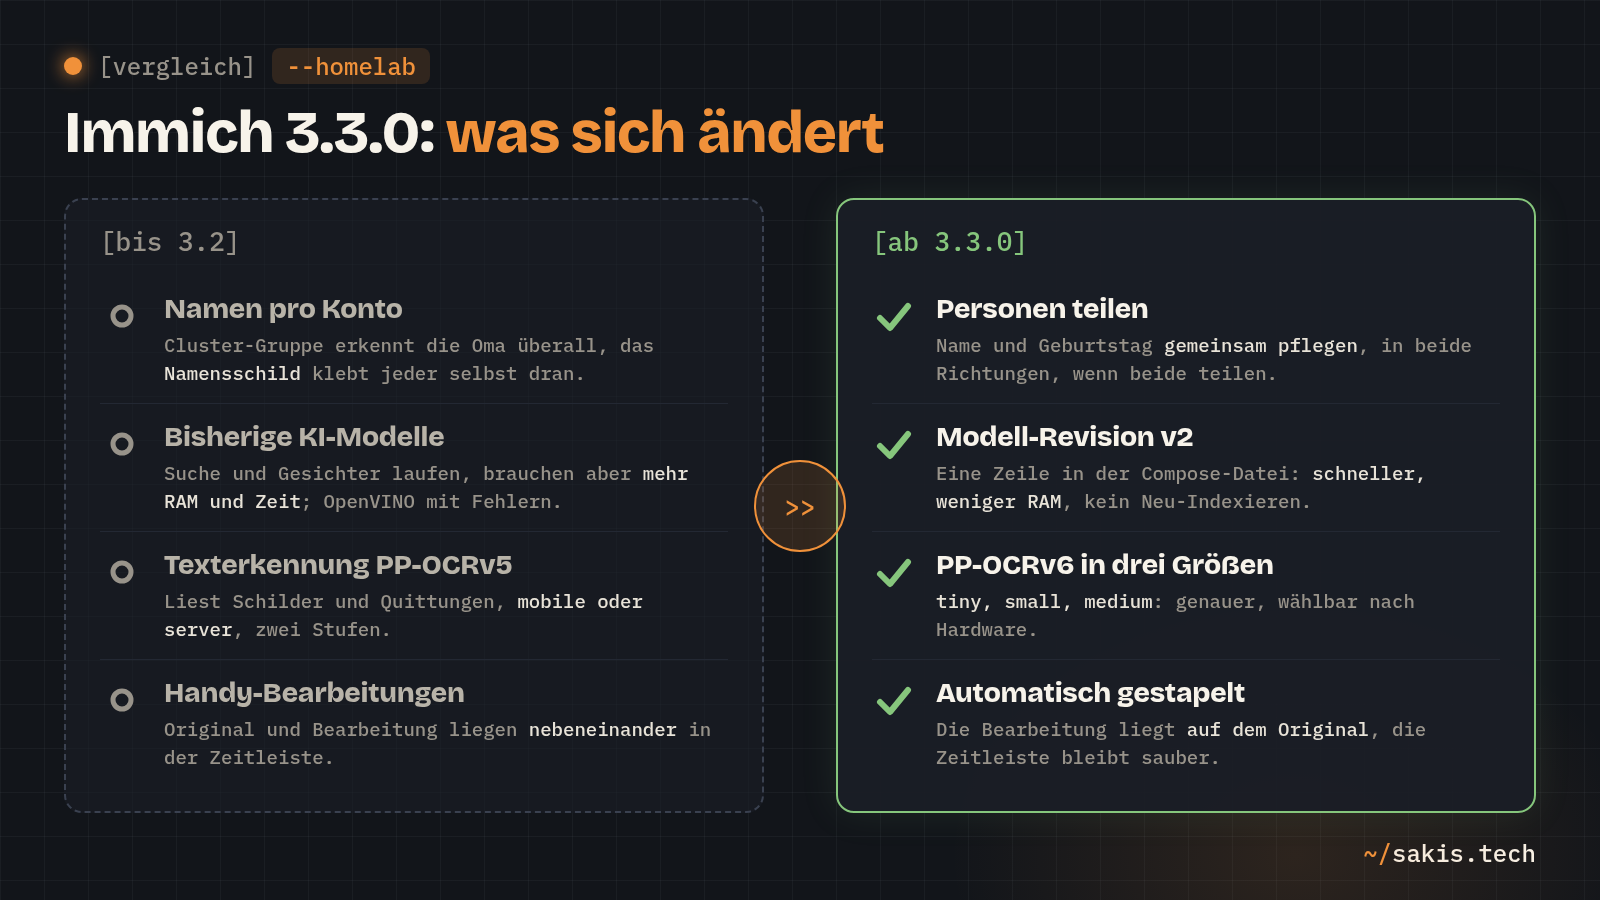
Personen teilen: das Namensschild wandert mit
Die Mechanik ist einfach, wenn man die Cluster-Gruppe aus 3.2 kennt: Leute auf derselben Instanz, die sich gegenseitig vertrauen, lassen ihre Gesichtserkennung gemeinsam arbeiten. Neu ist, dass du eine erkannte Person jetzt mit einem Mitglied dieser Gruppe teilen kannst. Sie taucht dann laut Release Notes in beiden Personenlisten auf, im Browser wie in der App, und beide dürfen Name und Geburtstag ändern. Mehr nicht, nur diese zwei Felder.
Ein Detail steht in den Release Notes und gehört hierher, weil es sonst für Verwirrung sorgt: Das Teilen ist gerichtet. Teilst du die Oma mit deinem Partner, sieht er sie und darf sie umbenennen. Damit seine Änderungen auch bei dir landen, muss er die Oma seinerseits mit dir teilen. Zwei Richtungen, zwei Handgriffe. Beim Bearbeiten im Browser gibt es dafür eine Auswahl, ob die Änderung für „alle mit Zugriff" oder nur für dich gilt. Das Fenster zum Verwalten des Zugriffs gibt es vorerst nur im Browser, nicht in der App.
Wie das in der Praxis ankommt, zeigt der Feedback-Thread, den das Team dafür auf GitHub eröffnet hat. Jemand berichtet nach einer halben Stunde Testen von null Problemen beim Teilen und Zusammenführen. Daneben stehen die Wünsche, die man erwartet hätte: ein Nur-Lesen-Modus, damit der Partner die Oma sehen, aber nicht umbenennen kann; ein sichtbares Zeichen an geteilten Personen; und bei acht Personen und acht Nutzern wird das Teilen zur Klickarbeit. Ein Nutzer meldet nach dem Zusammenführen kaputte Vorschaubilder. Das Team selbst nennt die Funktion in dem Thread zu etwa 80 Prozent fertig, die Doku soll nachkommen. Ich finde diese Ehrlichkeit angenehmer als ein Feature, das als fertig verkauft wird und es nicht ist.
Was bleibt, ist der Preis aus 3.2: Teilen setzt eine Cluster-Gruppe voraus, und die verlangt beim Einrichten einen Reset der Gesichtserkennung, bei dem Namen an Gesichtern verloren gehen. Wer damals gewartet hat, weil zweihundert benannte Personen auf dem Spiel standen, hat mit 3.3.0 keinen neuen Grund, es sich anders zu überlegen. Wer die Gruppe schon hat, bekommt jetzt das Stück, das gefehlt hat.
Geburtstage und gestapelte Bearbeitungen
Zwei kleinere Dinge aus derselben Ecke. Hat eine Person in deiner Bibliothek Geburtstag, baut Immich daraus jetzt eine eigene Erinnerung mit Bildern früherer Geburtstage, so wie die „Heute vor drei Jahren"-Karten. Das setzt natürlich voraus, dass du Geburtstage überhaupt eingetragen hast; die neue Teilen-Funktion hilft dabei, weil dann einer im Haushalt reicht.
Und wer Fotos auf dem Handy mit einer anderen App bearbeitet, bekommt die Bearbeitung ab sofort automatisch auf das Original gestapelt, statt dass beide einzeln in der Zeitleiste liegen. Kleine Sache, die man jeden Tag sieht.
Modell-Revision v2: eine Zeile, weniger Arbeitsspeicher
Das ist der Teil, für den ich updaten würde. Immich bringt neue, optimierte Versionen seiner Machine-Learning-Modelle mit, also der Programme, die Gesichter erkennen und zu jedem Bild berechnen, was darauf ist. Laut Release Notes laufen sie „deutlich schneller" und brauchen weniger Speicher, auf allen Backends einschließlich reiner CPU, also genau auf dem alten Büro-PC, auf dem bei vielen das Homelab läuft. Wie viel schneller, variiert laut Team je nach Modell und Backend; eine Zahl nennen sie nicht, und ich erfinde keine.
Drei Gruppen profitieren besonders: Wer mit OpenVINO auf Intel-Grafik beschleunigt und bisher falsche Ergebnisse hatte, soll die mit den neuen Modellen los sein. Rockchip-Boards mit RKNPU können jetzt alle Modelle beschleunigen, zum ersten Mal auch die Texterkennung. Und NVIDIA-Karten ab der 30er-Reihe nutzen TensorRT RTX.
Das Gute daran: Es ist Opt-in, und der Wechsel kostet nichts. Die Release Notes sagen ausdrücklich, dass alte und neue Modelle numerisch gleichwertige Ergebnisse liefern, du musst also nichts neu indexieren, keine Suche und keine Gesichtserkennung noch einmal laufen lassen. Nur das allererste Laden eines Modells dauert länger, weil der Container es einmal für deine Hardware vorbereitet; das Ergebnis wird im Modell-Cache behalten. Laut Immich-Blog wird v2 in einer späteren Version die Vorgabe. Du nimmst es dir jetzt schon.
Eingeschaltet wird es mit einer Umgebungsvariablen am Machine-Learning-Container. Wer Immich nach der Anleitung hier auf sakis.tech laufen hat, öffnet ~/immich/compose.yaml und ergänzt im Dienst immich-machine-learning unter volumes: diese zwei Zeilen, eingerückt wie die Nachbarn:
    environment:
      - MACHINE_LEARNING_MODEL_REVISION=v2
Wer die offizielle Zwei-Dateien-Variante nutzt, trägt die Zeile in der .env ein und reicht sie im Compose an den ML-Dienst durch; der Weg ist derselbe. Danach docker compose up -d im Immich-Ordner, Compose baut nur den geänderten Container neu. Ob es greift, siehst du beim nächsten Upload: Im Log des ML-Containers taucht das erste, langsame Laden auf, danach geht es flott. Und wenn dir etwas nicht gefällt, nimmst du die Zeile wieder raus; weil die Ergebnisse gleichwertig sind, bleibt deine Suche davon unberührt. Ein Umbau, den man rückgängig machen kann, ist die Sorte Umbau, die ich mag.
PP-OCRv6: Texterkennung in drei Größen
Immich liest seit ein paar Versionen Text in Bildern, Schilder, Speisekarten, Quittungen, und macht ihn durchsuchbar. Dafür kommt jetzt die Modellfamilie PP-OCRv6, die laut Release Notes „deutlich genauer" ist als die bisherige v5, weiterhin mehrsprachig. Neu ist die Auswahl: PP-OCRv6_tiny für bescheidene Hardware, PP-OCRv6_small als der Sprung, den das Team gegenüber dem alten PP-OCRv5_mobile hervorhebt, und PP-OCRv6_medium als genaueste und teuerste Stufe.
Das Modell wählst du im Browser unter Verwaltung, Einstellungen, Einstellungen für maschinelles Lernen, im Abschnitt zur Texterkennung (OCR) im Feld OCR-Modell. Für einen Server ohne Grafikkarte würde ich mit small anfangen; medium ist etwas für Rechner, bei denen die Lüfter nicht schon bei der Gesichtserkennung anspringen. Ehrlich dazu: Ob bereits verarbeitete Bilder vom neuen Modell profitieren, sagen die Release Notes nicht. Nach meinem Verständnis gilt ein neues Modell für alles, was ab dem Wechsel verarbeitet wird; für den Bestand müsste der OCR-Auftrag unter Verwaltung, Aufträge noch einmal über alle Bilder laufen, und das ist bei großen Bibliotheken eine Nachtarbeit. Das ist meine Schlussfolgerung, nicht ihre Aussage.
Drei Fixes und ein drei Jahre altes Issue
- Schärfere Vorschaubilder. Immich rechnet Thumbnails und Vorschauen jetzt mit einem genaueren Verfahren herunter; feine, kontrastreiche Details und die Helligkeit bleiben besser erhalten, die Vorher-Nachher-Bilder im Blog zeigen es deutlich. Das gilt für alles, was ab jetzt erzeugt wird. Ob du dafür den Auftrag „Vorschaubilder erzeugen" über die ganze Bibliothek anstoßen willst, entscheidest du selbst; ich würde es nicht tun, denn das sind Stunden CPU-Zeit für Bilder, die du bisher auch angesehen hast.
- OAuth-Angaben bei jedem Login. Wer seine Nutzer über einen Identitätsanbieter wie Authentik oder Keycloak anmeldet, konnte Speicherkontingent, Rolle und Benutzername bisher nur bei der Registrierung mitgeben. Jetzt werden sie bei jedem Login abgeglichen. Für Haushalte ohne eigenen Login-Server ändert das nichts; für die anderen ist es das Stück, das aktive Nutzerverwaltung erst möglich macht.
- Speicherplatz unter Docker auf dem Mac. Immich zeigte dort die Belegung um den Faktor 4096 oder mehr falsch an, weil die Blockgröße des Dateisystems anders gemeldet wurde, als Node.js sie bisher lesen konnte. Eine neue Node-Eigenschaft (
frsize) löst es. Das Issue dazu war laut Blog das viertälteste offene des Projekts, aufgemacht vor gut drei Jahren. Dass jemand das noch zu Ende gebracht hat, statt es als Kuriosität liegen zu lassen, freut mich mehr als jedes neue Feature.
Update: wie immer, und wer nichts tun muss
Breaking Changes nennen die Release Notes keine, und der Weg ist der aus der Doku: Release Notes lesen (erledigt), Datenbank sichern, dann im Immich-Ordner docker compose pull und docker compose up -d. Wer das Image wie in der Anleitung mit dem Tag v3 zieht, bekommt 3.3.0 beim nächsten Pull von selbst; wer die Version in der .env über IMMICH_VERSION festgepinnt hat, trägt dort erst v3.3.0 ein. Die Handy-App vorher aktualisieren, sie versteht laut Doku die aktuelle und die vorherige Hauptversion, der Server nur seine eigene.
Der Backup-Tick zum Mitschreiben: Immich sichert seine Datenbank nachts selbst, aber ein frischer Export unmittelbar vor dem Update kostet eine Minute unter Verwaltung, Aufträge, und ein Downgrade gibt es nicht. Ist der Dump da, ist der Weg zurück da.
Updaten würde ich ohne langes Überlegen, vier Wochen nach 3.2.0 und mit 22 Leuten, die hier zum ersten Mal beigetragen haben, ist 3.3.0 ein normaler Monatsschritt, kein Umbau. Die Zeile für die neuen Modelle würde ich auf jedem Server ohne Grafikkarte sofort setzen, weil sie nichts kostet und zurückgenommen werden kann. Die Personen-Freigabe ist etwas für die, die schon in einer Cluster-Gruppe sind; alle anderen warten weiter auf das Zusammenführen ohne Reset, und daran ändert diese Version nichts.
Hast du die Zeile gesetzt, und läuft die Suche auf deinem Server spürbar anders? Und teilst du schon Personen, oder hält dich der Reset aus 3.2 immer noch davon ab? Schreib's in die Kommentare.
Wer Immich noch gar nicht laufen hat, findet die im Sandkasten geprüfte Compose-Datei in der Installationsanleitung; wer von Google Fotos kommt, den Umzug mit immich-go.
Quellen
- Immich v3.3.0: Release Notes auf GitHub (07-10-2026)
- Immich-Blog: v3.3.0 (Modell-Revision v2 als künftige Vorgabe, OCR-Modelle, Speicherplatz-Issue)
- GitHub-Diskussion: Feedback zum Teilen von Personen
- Immich-Doku: Environment Variables (Machine-Learning-Container)
- Immich-Doku: Hardware-Accelerated Machine Learning (OpenVINO, RKNN, CUDA)
- Immich-Doku: Upgrading
- Immich-Doku: System Settings (Machine Learning, Bildeinstellungen)
- Immich: englische Sprachdatei der Oberfläche (Bezeichnung „OCR model")