„Treffen wir uns Dienstag, äh, nein, Mittwoch.“ So redet man. Bisher stand nach dem Diktieren genau dieser Satz im Textfeld, samt Dienstag und samt Äh. Googles neues Sprachmodell Gemini 3.5 Transcribe schreibt stattdessen: „Treffen wir uns Mittwoch.“ Google hat es am 26. August vorgestellt und nennt es sein bislang genauestes Modell für Sprache zu Text.
Das ist ein anderer Job als bisher. Die alte Diktierfunktion war ein Stenograf: Sie schrieb mit, was du gesagt hast, Fehler inklusive. Das neue Modell ist ein Lektor: Es schreibt auf, was du gemeint hast. Für Nachrichten und Notizen ist das ein Gewinn. Für alles, worauf es ankommt, ist es ein Grund zum Nachlesen, dazu unten mehr.
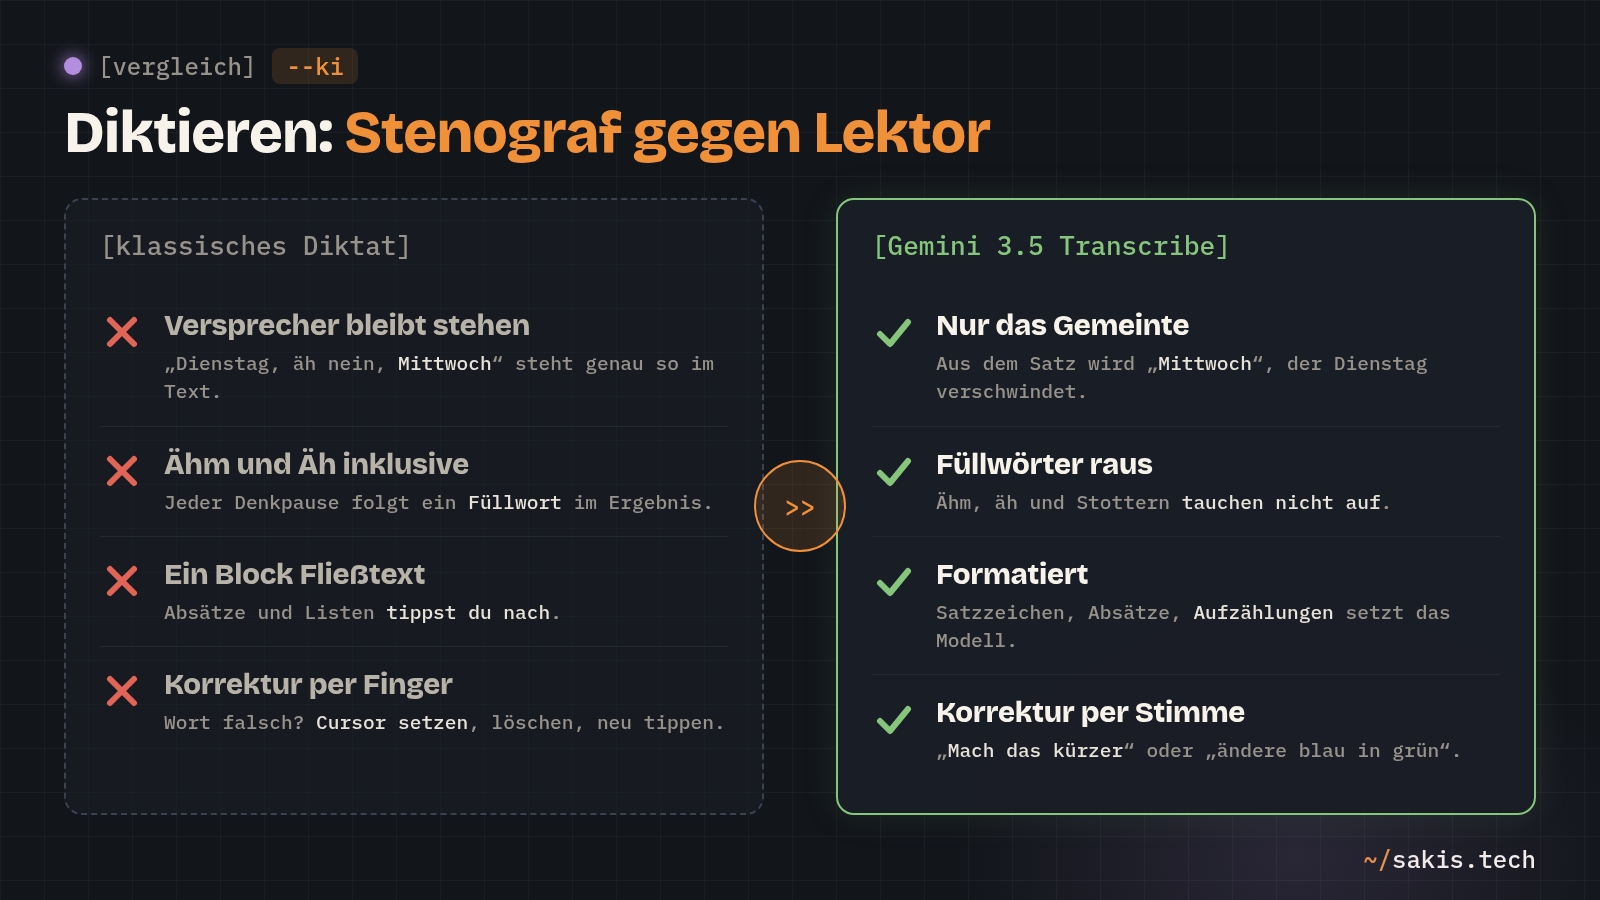
Was Gemini 3.5 Transcribe aus dem Gesagten macht
Drei Eingriffe nennt Google in der Ankündigung: Selbstkorrekturen werden aufgelöst, Füllwörter wie „ähm“ fliegen raus, und der Text bekommt Satzzeichen, Absätze und bei Bedarf Aufzählungen. Dazu kommt ein eigenes Vokabular: Bis zu 1.000 Begriffe kannst du dem Modell laut Entwickler-Doku mitgeben, damit es Produktnamen und Fachwörter so schreibt, wie du sie schreibst. Google empfiehlt dort rund 100, mehr wird offenbar nicht besser.
Bei Aufnahmen unterscheidet das Modell außerdem, wer gerade spricht, und setzt Zeitstempel je Wort. Offiziell sauber funktioniert das bis drei Personen. Mehr geht laut Doku auch, steht aber als experimentell markiert, und die Zeitstempel drücken laut derselben Doku die Genauigkeit etwas. Das Modell versteht über 85 Sprachen, erkennt sie selbst und kommt mit Sätzen klar, in denen mitten drin die Sprache wechselt.
Die Genauigkeit gibt Google als Wortfehlerrate an: 4,0 Prozent beim Live-Mitschreiben, 2,6 Prozent bei fertigen Aufnahmen.
Die Zahlen stammen von Google selbst, gemessen auf eigenen Testdaten; auf dem offenen Mehrsprachen-Test FLEURS nennt Google 5,5 und 5,0 Prozent. Ich würde die kleineren Werte als Bestfall lesen und den größeren als das, was bei Dialekt und Hintergrundgeräuschen eher rauskommt. Wer Zahlen diktiert, Bestellnummern, Postleitzahlen, IBAN, liest sowieso nach. Google sagt zwar, das Modell fange solche Zeichenketten besonders gut ein. Bei 2,6 Prozent Fehlern reicht mir das nicht als Versprechen.
Gegenüber dem Vorgänger Chirp 3 aus dem letzten Jahr soll der fertige Text 70 Prozent schneller dastehen. Das ist der Wert, der beim Diktieren am meisten zählt: Ob die Wörter kurz nach dem Sprechen erscheinen oder erst, wenn du schon den nächsten Satz im Kopf hast.
Wo du es bekommst: Pixel 11, Mac, bald Chrome
Auf Android steckt das Modell in Rambler, der neuen Diktierfunktion von Gboard. Rambler hatte Google im Mai auf der Android Show gezeigt, seit Mitte August ist es da. Laut Googles Hilfeseite läuft es vorerst nur auf der Pixel-11-Reihe, Deutsch ist dabei, und es braucht eine Internetverbindung. Ein Pixel 10 oder ein Galaxy schaut vorerst zu, obwohl Google im Mai noch beide Marken für den Sommer angekündigt hatte. Smartdroid hat das im August nachgezählt und die Lücke gefunden. Einschalten: Mikrofon auf der Tastatur antippen, im Dialog auf Start. Zurück zum alten Diktat geht über die Gboard-Einstellungen unter Spracheingabe.
Der zweite Ort ist die Gemini-App auf dem Mac, wo du per Stimme Befehle gibst und das Modell den Bildschirminhalt als Kontext mitnimmt. Der dritte ist Chrome: Dort soll das Diktat in jedes Textfeld einer Webseite kommen, Google sagt „bald“ und nennt kein Datum. Bis 7. September gab es dazu nichts Neues.
Entwickler bekommen das Modell über die Gemini-API und AI Studio, als öffentliche Vorschau. Eine Minute Audio kostet für fertige Aufnahmen umgerechnet rund einen halben US-Cent, eine Stunde Podcast also etwa 30 Cent. Die Live-Variante kostet fast das Doppelte und nimmt höchstens zehn Minuten am Stück, fertige Dateien dürfen bis zu einer Stunde lang sein. Es gibt eine kostenlose Stufe, und da steht in Googles Preisliste ein Satz, den du kennen solltest: Im Gratis-Tarif werden die Daten zur Verbesserung der Produkte verwendet, im bezahlten nicht.
Dein Diktat geht zu Google
Das ist der Teil, den die Ankündigung nur im Nebensatz erwähnt. Rambler verarbeitet Ton und Text nicht auf dem Handy, sondern bei Google. Die Hilfeseite formuliert es so: Text, Toneingabe und deine Korrekturen werden vorübergehend von Google verarbeitet, nie gespeichert oder geteilt und sofort nach der Zustellung des Textes gelöscht. Das ist eine klare Zusage, und ich habe keinen Grund, sie anzuzweifeln. Nachprüfen kann ich sie auch nicht, und das ist der Unterschied zur alten Offline-Spracheingabe, die auf dem Gerät blieb.
Für die Einkaufsliste und die Antwort im Familienchat ist mir das egal. Für das Diktat an den Arzt, den Anwalt oder die Personalabteilung würde ich vorher kurz überlegen, ob dieser Satz eine Reise nach Kalifornien braucht. Wer das grundsätzlich nicht will, hat mit Whisper von OpenAI ein offenes Modell, das auf dem eigenen Rechner läuft; TechCrunch zählt daneben ein halbes Dutzend Diktier-Apps auf, die Google mit Rambler das Geschäft schwer macht. Sauberes Diktieren war bis Mai ein Produkt, das man kaufte. Jetzt liegt es der Tastatur bei.
Wenn die Tastatur entscheidet, was du gemeint hast
Bleibt der Lektor. „Dienstag, nein, Mittwoch“ ist einfach. „Der Server steht im Keller, nein, im Rack“ auch. Aber ein Modell, das Versprecher auflöst, muss bei jedem Satz raten, ob das Zweite das Erste ersetzt oder ergänzt. „Nimm die Kabel, nein, die kurzen Kabel“ hat zwei richtige Lesarten. Google beschreibt in der Ankündigung nur den einfachen Fall, und ich habe keine Quelle gefunden, die den schwierigen misst.
Ich würde Rambler auf dem Pixel 11 einschalten und eine Woche lang alles damit diktieren, was ohnehin in einen Chat geht. Da kostet ein falsch aufgelöster Satz nichts, und du merkst schnell, wo der Lektor dich versteht und wo nicht. Was per Mail an jemanden geht, der dich nicht kennt, liest du vor dem Absenden einmal durch. Das hast du bisher auch gemacht, nur mit dem Unterschied, dass du früher deine eigenen Fehler gesucht hast und jetzt die des Modells.
Wie viel darf eine Tastatur an deinen Sätzen ändern, bevor es nicht mehr dein Text ist? Reicht dir „Füllwörter raus“, oder soll sie ruhig auch den Ton glätten, wenn du sie darum bittest? Und würdest du dafür in Kauf nehmen, dass jedes Diktat kurz über einen Google-Server läuft? Schreib mir deine Grenze in die Kommentare.
Google hat in derselben Woche noch ein zweites Modell nachgelegt, diesmal für Video: Gemini Omni 1.1 Flash dreht jetzt 40 Sekunden, und auch dort steckt die interessante Zahl nicht in der Überschrift. Wer solche Einordnungen lieber sonntags gesammelt im Postfach hat, findet das Newsletter-Feld gleich unter diesem Beitrag.
Quellen
- Google: Intelligent transcription with Gemini 3.5 Transcribe (Ankündigung, 26. August 2026)
- Google AI for Developers: Gemini 3.5 Transcribe (Modell-Doku: Limits, Sprecher, Vokabular)
- Google AI for Developers: Gemini API Pricing (Preise, Datennutzung im Gratis-Tarif)
- Google Gboard-Hilfe: Rambler voice input on Gboard (Geräte, Sprachen, Datenverarbeitung)
- 9to5Google: Google launches Gemini 3.5 Transcribe, which powers Gboard Rambler and is coming to Chrome
- The Decoder: Gemini 3.5 Transcribe turns speech to text in 85 languages (Vergleich mit Chirp 3)
- TechCrunch: Google adds Gemini-powered dictation to Gboard (Android Show, 12. Mai 2026)
- Smartdroid: Gboard auf Pixel: Neue Spracheingabe für Deutschland (13. August 2026)